人工智能发展太缓慢?开发新的自适应技术是否成为关键突破口
人工智能在图像识别、自然语言处理、推荐系统等领域取得了显著进展,但越来越多从业者与观察者开始提出一个尖锐问题:人工智能的发展是否正在放缓?一方面,大模型的参数规模不断膨胀,训练成本高企,而真正能够实现通用智能、持续学习与环境自适应能力的系统仍然遥远。另一方面,大量AI应用软件在落地时面临场景碎片化、数据分布漂移、用户需求多变等现实瓶颈,导致模型部署后性能迅速衰减。在这个背景下,开发新的自适应技术,被很多人视为推动人工智能从“实验室爆发”走向“工程化持续进化”的关键。
当前人工智能之所以被认为“缓慢”,并不是指不存在进步,而是指这种进步越来越依赖于算力与数据规模的线性堆叠,缺乏类似生物智能那样的自我调节与快速适应机制。传统机器学习范式要求训练集与测试集满足独立同分布假设,但真实世界中的AI应用软件——无论是智能客服、工业质检、自动驾驶还是医疗辅助诊断——其运行环境总是在变化。光照改变、季节更替、用户行为迁移、新出现的疾病变种,都会让静态模型迅速失效。而重新标注数据、重新训练模型、重新部署上线的循环,往往耗时数周甚至数月,无法满足实时业务需求。因此,自适应技术成为打破僵局的重要方向。
什么是AI自适应技术?广义上,它指模型或系统在部署后能够根据新数据、新任务、新环境自动调整自身参数、结构或策略的能力。它至少包含三个层次:第一是参数级自适应,例如在线学习、元学习、少样本微调,使模型仅用少量新样本即可快速更新;第二是特征与表示级自适应,如领域自适应、分布鲁棒优化,让模型在不同数据分布之间保持稳定;第三是架构与策略级自适应,包括神经架构搜索的动态版本、模块化网络、持续学习与记忆回放机制,使系统能够在不遗忘旧知识的前提下纳入新知识。对于人工智能应用软件开发而言,自适应技术直接决定了产品的生命周期与用户体验。
为什么自适应技术可能成为关键?它能显著降低维护成本。没有自适应能力的AI应用软件,一旦上线就必须依赖持续的数据回流与人工迭代,运维成本几乎与研发成本相当。而具备在线自适应能力的系统,则可以自动检测概念漂移并触发局部更新,大幅减少人工干预。自适应技术能让单一AI软件覆盖更长尾的场景。例如一个面向多个城市的交通流量预测系统,如果具备元学习与快速适应能力,就不需要为每个城市单独训练模型,而是共享通用知识并实现城市级微调。第三,自适应是通往更通用人工智能的必经之路。真正智能的系统不应只在训练分布内表现良好,而应在开放动态环境中持续生存与进化。
目前,产业界与学术界已经在自适应技术方面取得一些值得关注的进展。例如,持续学习通过弹性权重巩固、经验回放等方法缓解灾难性遗忘;在线元学习让模型在推理阶段进行少量梯度更新,从而适应新任务;测试时自适应则允许模型在推理时利用无标签测试数据调整批归一化统计量或预测策略。这些技术已经开始嵌入到一些先进的AI应用软件开发框架中,用于提升模型在边缘设备、隐私受限环境以及流式数据场景下的表现。现有自适应技术仍面临若干根本挑战:稳定性与可塑性之间的权衡难以调和,自适应过程可能引入噪声与对抗风险,长期自主更新缺乏可靠的评估与安全护栏,算力与存储开销在端侧应用中仍然过高。
因此,要真正让自适应技术成为人工智能发展的关键突破口,还需要在多个层面协同推进。理论层面,需要建立更完善的动态分布学习理论与泛化边界,理解模型在持续变化环境中的行为规律。算法层面,应发展轻量级、可解释、可验证的自适应机制,避免“黑箱式”悄悄漂移。工程层面,AI应用软件开发工具链需要内建自适应模块与监控体系,让开发者能够像配置日志和缓存一样配置自适应策略。治理层面,必须建立自适应系统的审计与回滚机制,确保模型变化符合法规、伦理与业务约束。
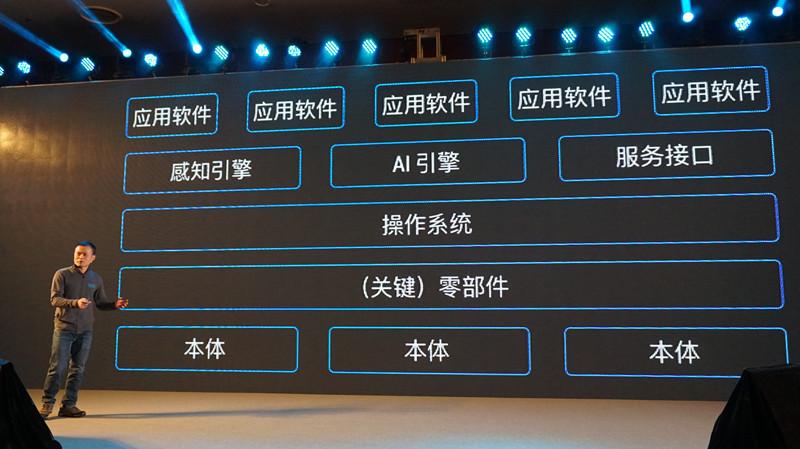
可以预见,未来的AI应用软件将不再是一经训练便固定不变的静态制品,而是具备生命周期感知、环境感知与自我更新能力的动态系统。那种“一个模型打天下、一次训练管三年”的范式将逐渐让位于“基础模型 + 自适应层 + 持续学习回路”的新架构。人工智能的发展是否缓慢,答案取决于我们用什么尺度衡量。如果只看下一轮参数规模翻倍,也许瓶颈已经显现;但如果转向自适应能力的突破,那么整个领域才刚刚进入一个更激动人心的阶段。开发新的自适应技术,很可能正是那关键的一步。
如若转载,请注明出处:http://www.24counts.com/product/45.html
更新时间:2026-11-01 07:14:23